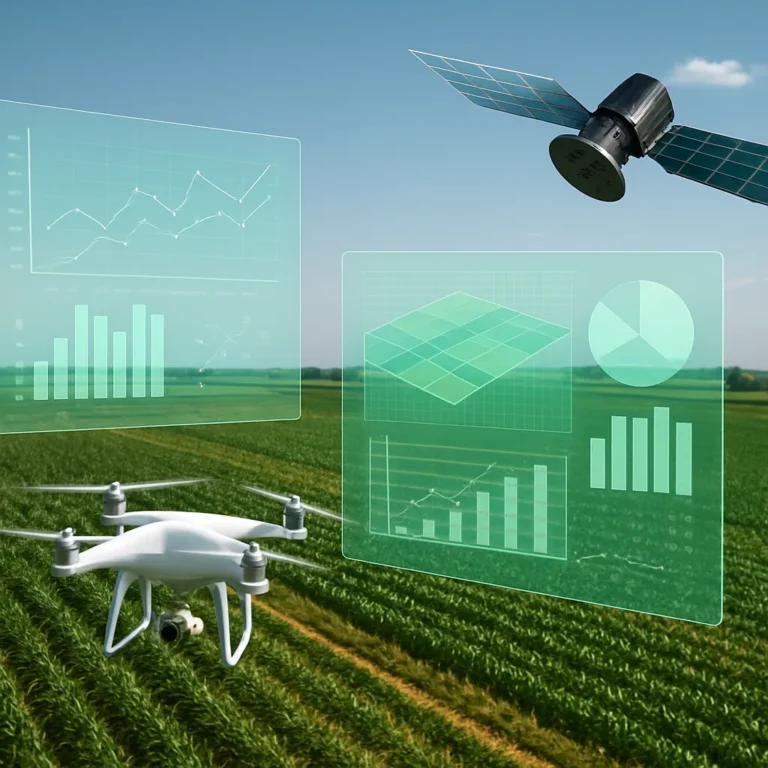
Analiza danych klimatycznych coraz silniej wpływa na decyzje podejmowane w rolnictwie, od wyboru odmian roślin po sposób nawożenia i planowanie zbiorów. Rozwój Internetu Rzeczy, satelitów, dronów i systemów informacji geograficznej sprawia, że rolnicy i doradcy dysponują bezprecedensową ilością informacji o glebie, pogodzie, stanie plantacji i rynku. Z tego oceanu informacji rodzi się koncepcja Big Data w uprawach: zintegrowane, szeroko zakrojone analizy, które pomagają ograniczać ryzyko klimatyczne, zwiększać plon, redukować koszty i lepiej dopasowywać odmiany do lokalnych warunków. Kluczowe staje się przekształcenie surowych danych w praktyczne rekomendacje polowe, zrozumiałe i użyteczne dla producentów rolnych, firm nasiennych i doradców agrotechnicznych.
Znaczenie Big Data w rolnictwie i uprawach roślin
Big Data w rolnictwie oznacza pracę z ogromnymi, szybko zmieniającymi się zbiorami informacji, pochodzącymi z wielu źródeł jednocześnie. Sercem tego podejścia jest nie tylko sam wolumen danych, ale też ich różnorodność oraz możliwość bieżącego przetwarzania. W realiach pól uprawnych oznacza to korzystanie m.in. z:
- danych meteorologicznych z wielu lat – stacji naziemnych, radarów, satelitów oraz lokalnych czujników pogodowych,
- danych glebowych – map glebowych, analiz laboratoryjnych, pomiarów wilgotności i zasobności składników pokarmowych,
- obserwacji polowych – zdjęć z dronów, kamer na maszynach, notatek agronomicznych, rejestrów zabiegów agrotechnicznych,
- danych maszynowych – zapisy GPS, zużycie paliwa, prędkość pracy, głębokość uprawy, dawki nawozów i środków ochrony,
- danych ekonomicznych – ceny zboża i nasion, koszty środków produkcji, stawki usług polowych, dopłaty i ubezpieczenia,
- wyników plonowania – dane z kombajnów wyposażonych w mapowanie plonu, protokoły z doświadczeń odmianowych.
Taka mozaika informacji pozwala przejść z intuicyjnego, opartego jedynie na doświadczeniu podejścia do precyzyjnego, obliczeniowego zarządzania produkcją roślinną. Big Data nie zastępuje wiedzy rolnika, lecz ją rozszerza – dostarcza kontekstu, wskazuje zależności niewidoczne gołym okiem oraz pomaga obiektywnie oceniać efekty stosowanych technologii.
Rosnące zmiany klimatu sprawiają, że powtarzalność warunków pogodowych z poprzednich dekad przestaje być pewnym punktem odniesienia. Coraz częściej obserwuje się ekstremalne zjawiska: długotrwałe susze, gwałtowne opady, przymrozki w nietypowych porach roku czy fale upałów w kluczowych fazach rozwojowych roślin. Big Data w połączeniu z zaawansowaną analizą danych klimatycznych pozwala modelować scenariusze przyszłych sezonów, oceniać ryzyko i lepiej przygotowywać strategie zarządzania gospodarstwem.
W tym kontekście kluczowym zagadnieniem staje się dobór odmian: takich, które najlepiej poradzą sobie w określonych warunkach siedliskowych i pogodowych, a jednocześnie sprostają wymaganiom rynku i regulacjom. Analiza wieloletnich baz danych klimatycznych, wyników doświadczeń odmianowych i ekonomiki produkcji umożliwia precyzyjne dopasowanie genetyki roślin do mikroklimatu konkretnego pola.
Źródła i rodzaje danych klimatycznych wykorzystywanych w uprawach
Podstawą analizy danych klimatycznych w rolnictwie jest zrozumienie, z jakich źródeł pochodzą informacje oraz jakiego rodzaju parametry są najistotniejsze dla rozwoju roślin. Im dokładniej poznane zostaną lokalne warunki klimatyczne, tym precyzyjniej można dobrać odmianę, termin siewu, strategie nawożenia czy ochrony roślin.
Stacje meteorologiczne i systemy satelitarne
Tradycyjne stacje meteorologiczne dostarczają ciągłych pomiarów temperatury, opadów, nasłonecznienia, wilgotności względnej, prędkości i kierunku wiatru. W rolnictwie duże znaczenie mają zwłaszcza:
- sumy opadów w ciągu sezonu wegetacyjnego oraz ich rozkład w czasie,
- dobowe i godzinowe temperatury powietrza – decydujące o tempie wzrostu i rozwoju fenologicznego roślin,
- liczba dni z przymrozkami, falami upałów, burzami gradowymi,
- usłonecznienie, wpływające na intensywność fotosyntezy i kształtowanie plonu.
Nowoczesne analizy Big Data coraz częściej korzystają z danych satelitarnych, które umożliwiają obserwację dużych obszarów z wysoką częstotliwością. Dane te pozwalają m.in. monitorować indeksy wegetacyjne (np. NDVI), temperaturę powierzchni, wilgotność gleby oraz dynamikę rozwoju roślin. Z punktu widzenia wyboru odmian stanowią one cenne źródło informacji o reakcji konkretnych genotypów na warunki panujące w poszczególnych sezonach.
Stacje lokalne i Internet Rzeczy w polu
Uzupełnieniem sieci państwowych stacji meteorologicznych są prywatne stacje pogodowe instalowane w gospodarstwach. Łączność bezprzewodowa i Internet Rzeczy umożliwiają zbieranie danych klimatycznych z dużą dokładnością przestrzenną, często z dokładnością do pojedynczego pola. Do najczęściej monitorowanych parametrów należą:
- temperatura powietrza na różnych wysokościach,
- temperatura gleby na kilku głębokościach (np. 5, 10, 20 cm),
- wilgotność gleby i poziom wód gruntowych,
- wilgotność powietrza i punkt rosy,
- intensywność i czas trwania opadu,
- prędkość wiatru oraz kierunek, ważne m.in. dla zabiegów ochrony roślin.
Połączenie danych meteorologicznych z lokalnych stacji z danymi satelitarnymi i radarowymi tworzy gęstą sieć obserwacyjną, która zasila modele prognostyczne. Na tej podstawie systemy Big Data generują prognozy pogody dostosowane do konkretnego gospodarstwa, a nawet fragmentu pola. Tak szczegółowe dane są kluczowe dla oceny ryzyka wystąpienia stresów termicznych i wodnych, które silnie wpływają na dobór odmiany.
Historyczne serie danych i ekstremalne zjawiska pogodowe
Analiza Big Data obejmuje nie tylko dane bieżące, ale przede wszystkim długie serie historyczne, sięgające nawet kilkudziesięciu lat. Pozwala to odpowiedzieć na pytania istotne dla strategii odmianowej:
- Jak często występują w danym regionie wiosenne przymrozki po terminie siewu i wschodów?
- Jak zmienia się rozkład opadów: czy rośnie częstotliwość susz letnich, czy okresów nadmiernych deszczy?
- Jak często notuje się fale upałów w okresie kwitnienia zbóż, rzepaku czy kukurydzy?
- Jak zmieniają się minimalne i maksymalne temperatury zimą, wpływające na wymarzanie roślin ozimych?
Zestawienie takich informacji z wynikami plonowania poszczególnych odmian w wielu lokalizacjach i latach pozwala tworzyć profile odporności na stres: suszę, mróz, choroby związane z nadmiarem wilgoci czy uszkodzenia mrozowe. Dzięki temu możliwe jest dopasowanie odmiany nie tylko do typowego, ale i do potencjalnie ekstremalnego scenariusza pogodowego w danym regionie.
Modelowanie agroklimatu i stref uprawy
Zaawansowane systemy Big Data wykorzystują zintegrowane modele agroklimatyczne, które łączą informacje o klimacie, glebie i praktykach agrotechnicznych. Na tej podstawie tworzy się strefy uprawy – obszary o zbliżonych warunkach klimatyczno-glebowych, w których rośliny reagują w podobny sposób. Dla każdej strefy można opracować rekomendacje dotyczące:
- gatunków i typów roślin najlepiej przystosowanych do lokalnych warunków,
- odmian o określonej długości okresu wegetacji (wczesnych, średnio wczesnych, późnych),
- wymaganego poziomu odporności na mróz, choroby czy suszę,
- ryzyka szkód wyrządzanych przez przymrozki, szkodniki i patogeny klimatozależne.
Takie podejście zapewnia znacznie większą precyzję niż tradycyjne dzielenie kraju na duże regiony uprawy. Mikroklimat konkretnego pola, wynikający z rzeźby terenu, typu gleby, ekspozycji na wiatr czy sąsiedztwa lasów i zbiorników wodnych, może diametralnie zmieniać efektywność danej odmiany. Big Data pozwala schodzić do coraz niższego poziomu szczegółowości, a więc personalizować dobór materiału siewnego.
Analiza danych klimatycznych a wybór odmiany roślin
Dobór odmiany jest jednym z najbardziej strategicznych decyzji w produkcji roślinnej. Materiał siewny definiuje potencjał plonowania, odporność na stresy abiotyczne i biotyczne, wymagania glebowe oraz reakcję na intensywność nawożenia. Analiza danych klimatycznych w ujęciu Big Data pozwala uczynić ten wybór bardziej obiektywnym i dostosowanym do lokalnych warunków, a nie tylko do ogólnych zaleceń katalogowych.
Parametry klimatyczne kluczowe dla doboru odmiany
Każda roślina ma określone wymagania klimatyczne, a w obrębie gatunku poszczególne odmiany różnią się m.in. długością okresu wegetacji, tolerancją na temperaturę, zapotrzebowaniem na wodę i światło. Analiza Big Data wyodrębnia kilka głównych grup parametrów klimatycznych istotnych przy wyborze odmiany:
- suma temperatur efektywnych (stopniodni) w sezonie wegetacyjnym – decyduje, czy dana odmiana zdąży zakończyć rozwój przed nadejściem niekorzystnych warunków,
- statystyczne ryzyko przymrozków wiosennych i jesiennych – wpływa na bezpieczeństwo odmian wcześnie wschodzących i późno dojrzewających,
- rozkład opadów i częstotliwość susz w krytycznych fazach (krzewienie, strzelanie w źdźbło, kwitnienie, nalewanie ziarna),
- prawdopodobieństwo występowania wysokich temperatur w czasie kwitnienia, mogących ograniczać zapylenie i formowanie ziarna,
- długość okresu zalegania pokrywy śnieżnej i ekstremalne spadki temperatur zimą – kluczowe dla roślin ozimych.
Na podstawie takich informacji buduje się profile klimatyczne poszczególnych lokalizacji. Z kolei dla odmian określa się ich wymagania i tolerancje na podstawie wieloletnich doświadczeń rejestrowych i porejestrowych. System Big Data łączy te dwa światy, dopasowując parametry odmiany do charakterystyki klimatycznej pola.
Łączenie danych klimatycznych z wynikami plonowania
Istotą Big Data w doborze odmiany nie jest sama znajomość klimatu, lecz umiejętność powiązania go z wynikami plonowania i zdrowotności roślin. W praktyce oznacza to analizę tysięcy doświadczeń polowych, prowadzonych w różnych latach i warunkach, oraz integrowanie ich z danymi pogodowymi z tych samych okresów. W ten sposób można:
- identyfikować odmiany stabilne plonująco – takie, które utrzymują relatywnie wysokie plony zarówno w latach suchych, jak i wilgotnych,
- wskazywać odmiany specjalistyczne – doskonale radzące sobie w określonych warunkach (np. tolerancyjne na suszę lub na nadmiar wody),
- oceniać, jak poszczególne odmiany reagują na ekstremalne zjawiska (przymrozki, upały, ulewy) w krytycznych fazach rozwoju,
- modelować potencjalny plon w danych warunkach przy przyjętym poziomie nawożenia i ochrony.
U podstaw leżą algorytmy statystyczne i uczenia maszynowego, które wykrywają wzorce w danych: np. że dana odmiana odmładza plon przy niedoborze wody w fazie strzelania w źdźbło, ale jest odporna na suszę w późniejszych fazach rozwoju. Takie wnioski byłyby trudne do wychwycenia na podstawie pojedynczych doświadczeń, lecz stają się widoczne, gdy system analizuje tysiące rekordów równocześnie.
Indywidualizacja rekomendacji odmianowych dla konkretnego pola
Tradycyjnie rekomendacje odmianowe są przygotowywane na poziomie regionów lub kraju. Big Data pozwala zejść na znacznie niższy poziom szczegółowości – do konkretnego pola lub nawet jego fragmentu. Warunkiem jest dostęp do:
- danych o historii pola – uprawiane gatunki, zastosowane odmiany, wyniki plonowania, historia nawożenia i ochrony,
- szczegółowych danych glebowych – typ gleby, klasa bonitacyjna, zasobność w składniki pokarmowe, pojemność wodna,
- mikroklimatu – lokalne warunki pogodowe, ukształtowanie terenu, ekspozycja na wiatr, ryzyko zastoisk mrozowych,
- celów produkcyjnych – maksymalny plon, jakość ziarna lub surowca, wymogi kontraktu z odbiorcą.
System rekomendacyjny, bazujący na Big Data, łączy te informacje z ogromnymi bazami wyników odmianowych i danych klimatycznych. W efekcie rolnik może otrzymać listę odmian posortowanych według dopasowania do jego konkretnego pola, uwzględniających ryzyko przymrozków, prawdopodobieństwo suszy, potencjał plonowania i stabilność w zmiennych warunkach. Taka indywidualizacja zwiększa szansę, że wybrana odmiana wykorzysta potencjał siedliska, jednocześnie ograniczając ryzyko strat w latach nietypowych.
Scenariusze klimatyczne i długoterminowa strategia odmianowa
Zmiany klimatu wymuszają myślenie o doborze odmian w perspektywie kolejnych 5–10 lat, a nie tylko nadchodzącego sezonu. Big Data, korzystając z modeli klimatycznych, pozwala budować scenariusze możliwych zmian: np. wydłużenie okresu wegetacyjnego, częstsze susze letnie czy łagodniejsze zimy. Na tej podstawie firmy hodowlane i rolnicy mogą kształtować długoterminową strategię odmianową:
- stopniowo wprowadzać odmiany o dłuższym okresie wegetacji, tam gdzie rośnie suma temperatur efektywnych,
- wybierać odmiany o podwyższonej tolerancji na wysokie temperatury w okresie kwitnienia,
- stawiać na genotypy o głębszym systemie korzeniowym i lepszym wykorzystaniu wody glebowej,
- ograniczać udział odmian wrażliwych na łagodne zimy i większą presję chorób grzybowych.
Strategia taka nie polega na gwałtownej wymianie całego portfela odmian, lecz na świadomym kształtowaniu go w oparciu o dane, stopniowo adaptując produkcję do nowej rzeczywistości klimatycznej. Big Data pełni tu rolę kompasu, wskazującego najbardziej prawdopodobne kierunki zmian i pozwalającego redukować niepewność towarzyszącą rolnictwu.
Big Data w praktyce gospodarstwa: integracja, narzędzia i wyzwania
Choć koncepcja Big Data brzmi technicznie, jej celem jest praktyczne wsparcie decyzji na poziomie gospodarstwa. Kluczowym zagadnieniem staje się integracja wielu strumieni danych w spójnym systemie oraz ich przełożenie na konkretne działania agrotechniczne, ekonomiczne i organizacyjne.
Systemy zarządzania gospodarstwem (FMIS) i platformy danych
W centrum nowoczesnego rolnictwa cyfrowego znajduje się system zarządzania gospodarstwem (Farm Management Information System – FMIS). Jest to platforma informatyczna, która gromadzi dane z różnych źródeł:
- rejestry zabiegów polowych i historia upraw,
- dane z maszyn rolniczych (GPS, mapy plonu, dawki, prędkość pracy),
- dane pogodowe z lokalnych stacji i serwisów meteorologicznych,
- informacje glebowe oraz mapy zasobności,
- dane ekonomiczne – koszty, przychody, wyniki sprzedaży plonów.
System FMIS pełni rolę huba danych, który łączy te informacje w jednym miejscu i umożliwia ich analizę. W połączeniu z modułem analitycznym Big Data, platforma może generować rekomendacje dotyczące wyboru odmian, optymalizacji dawek nawozów, terminów siewu, a nawet zarządzania ryzykiem pogodowym poprzez ubezpieczenia upraw.
Rolnictwo precyzyjne i zmienna dawka w oparciu o Big Data
Istotnym obszarem zastosowania Big Data jest rolnictwo precyzyjne, oparte na różnicowaniu zabiegów w obrębie pola. Rzadko kiedy pole jest jednorodne – występują zmiany w typie gleby, zawartości składników pokarmowych, wilgotności czy podatności na suszę. Big Data pozwala tworzyć szczegółowe mapy zmienności i dostosowywać do nich zarówno wybór odmian, jak i technologię uprawy:
- na częściach pola narażonych na suszę stosuje się odmiany bardziej tolerancyjne na niedobór wody,
- w fragmentach o wysokiej zasobności gleby można wprowadzać odmiany o wysokim potencjale plonowania,
- tam, gdzie częściej zalega woda, preferowane są odmiany o lepszej odporności na choroby podstawy źdźbła i zgorzele,
- dawki nawozów azotowych i regulacja łanu mogą być optymalizowane w zależności od vigor odmiany i żyzności stanowiska.
Maszyny wyposażone w systemy zmiennej dawki (VRA – Variable Rate Application) i precyzyjne prowadzenie równoległe potrafią aplikować różne ilości nawozu lub środków ochrony na poszczególnych częściach pola, zgodnie z mapami wygenerowanymi przez system Big Data. W ten sposób optymalizuje się relację między plonem, kosztami i wpływem na środowisko.
Dane z kombajnów i analiza powrotna (yield analytics)
Kombajny zbożowe coraz częściej wyposażone są w systemy pomiaru plonu i wilgotności ziarna w czasie rzeczywistym. Dane te, zlokalizowane za pomocą GPS, tworzą mapy plonu, które są jednym z najcenniejszych zasobów informacji zwrotnej w gospodarstwie. Analiza Big Data wykorzystuje je do:
- oceny efektywności poszczególnych odmian w różnych częściach pola,
- weryfikacji skuteczności zabiegów agrotechnicznych (np. zróżnicowanego nawożenia),
- identyfikacji stref o stałym niskim lub wysokim potencjale produkcyjnym,
- budowania lokalnych modeli plonowania w zależności od klimatu i zarządzania.
Jeśli rolnik de facto testuje kilka odmian na jednym polu, a dane z kombajnu są właściwie opisane (hybryda, termin siewu, dawki nawozów), Big Data może porównać ich wyniki w identycznych warunkach pogodowych. Na tej podstawie łatwiej jest zdecydować, którą odmianę rozwinąć na większą powierzchnię w kolejnym roku.
Współpraca z doradcami i firmami nasiennymi
Big Data zmienia także relacje między rolnikami, doradcami a firmami hodowlanymi i nasiennymi. Zamiast ogólnych zaleceń katalogowych możliwe jest wspólne wypracowanie rekomendacji opartych na danych z konkretnego gospodarstwa i regionu. Firmy nasienne, analizując wyniki odmian w tysiącach lokalizacji, tworzą profile odmian i propozycje ich wykorzystania na polach o różnych cechach klimatyczno-glebowych.
Doradcy polowi, korzystając z narzędzi Big Data, mogą:
- przedstawiać scenariusze plonowania różnych odmian przy zróżnicowanym przebiegu pogody,
- pokazywać, jak odmiana reaguje na przyspieszenie lub opóźnienie terminu siewu,
- oceniać opłacalność ekonomiczną poszczególnych wariantów produkcyjnych,
- monitorować ryzyko i proponować działania ograniczające straty (np. dopasowanie struktury zasiewów).
Współpraca taka tworzy ekosystem wymiany danych, w którym informacje płyną w obie strony: z gospodarstw do systemów analitycznych i z systemów do gospodarstw w formie praktycznych rekomendacji.
Wyzwania etyczne, własność danych i cyberbezpieczeństwo
Rozwój Big Data w rolnictwie rodzi także wyzwania pozatechniczne. Kluczowe kwestie dotyczą:
- własności danych – kto jest właścicielem danych generowanych przez maszyny, czujniki i systemy? rolnik, producent sprzętu, dostawca oprogramowania, czy wszyscy po części?
- prywatności i poufności informacji – dane o plonach, technologiach, kosztach produkcji są wrażliwe biznesowo,
- bezpieczeństwa cyfrowego – systemy rolnictwa precyzyjnego i platformy danych muszą być odporne na ataki cybernetyczne i utratę danych,
- transparentności algorytmów – ważne jest, aby rolnicy rozumieli, na jakich podstawach algorytm proponuje daną odmianę czy zabieg.
Rozwiązaniem jest rozwój standardów i regulacji dotyczących zarządzania danymi rolniczymi, jasne umowy pomiędzy stronami oraz budowa zaufania do dostawców usług cyfrowych. Big Data ma służyć przede wszystkim producentom rolnym, wzmacniając ich pozycję konkurencyjną i umożliwiając lepsze wykorzystanie zasobów, a nie wprowadzać dodatkowe ryzyko.
Rola sztucznej inteligencji i modeli językowych w analizie danych klimatycznych
Następnym etapem ewolucji Big Data w rolnictwie jest integracja metod sztucznej inteligencji, w tym modeli językowych i systemów uczenia głębokiego. Pozwalają one na bardziej zaawansowaną analizę danych klimatycznych i rolniczych oraz na przetłumaczenie wyników analiz na zrozumiały język rekomendacji dla użytkownika.
Uczenie maszynowe w prognozowaniu plonu i ryzyka
Algorytmy uczenia maszynowego analizują historyczne dane pogodowe, glebowe, agrotechniczne i plonowe, aby budować modele prognozujące. W rolnictwie znajdują one zastosowanie m.in. do:
- krótkoterminowego prognozowania plonu na podstawie aktualnego stanu upraw i prognozy pogody,
- oceny prawdopodobieństwa wystąpienia chorób i szkodników klimatozależnych,
- prognozowania ryzyka strat spowodowanych przymrozkami, suszą czy upałami,
- optymalizacji terminów siewu i zbioru pod kątem maksymalizacji plonu i jakości.
Takie modele mogą uwzględniać specyfikę odmian, które różnie reagują na warunki środowiskowe. W efekcie rolnik otrzymuje bardziej dopasowane scenariusze: jak zmieni się przewidywany plon odmiany A lub B, jeśli w maju wystąpi susza, a w czerwcu obfite opady.
Modele językowe jako interfejs do Big Data
Modele językowe, takie jak systemy generatywne, pełnią funkcję inteligentnej warstwy komunikacyjnej nad danymi i algorytmami. Potrafią:
- odpowiadać na pytania rolnika w języku naturalnym, np. o optymalną odmianę dla konkretnego pola,
- wyjaśniać złożone zależności klimatyczno-plonowe w prosty, zrozumiały sposób,
- pomagać w interpretacji raportów i map generowanych przez systemy Big Data,
- dostosowywać język komunikacji do poziomu wiedzy i preferencji użytkownika.
Połączenie Big Data z modelami językowymi otwiera drogę do tworzenia cyfrowych doradców rolniczych, dostępnych 24/7, którzy potrafią nie tylko wskazać rekomendowaną odmianę, ale też uzasadnić wybór, wskazując na konkretne dane klimatyczne i wyniki plonowania z podobnych warunków.
Automatyzacja dokumentacji i integracja rozproszonych źródeł wiedzy
Istotną rolą sztucznej inteligencji jest także automatyzacja przetwarzania dokumentów i raportów eksperckich. W rolnictwie funkcjonują tysiące stron opisów odmian, sprawozdań z doświadczeń, zaleceń agrotechnicznych i publikacji naukowych. Modele językowe mogą:
- automatycznie wydobywać kluczowe informacje z dokumentów, takie jak parametry odmian czy wyniki doświadczeń,
- integrować je z danymi liczbowymi w systemach Big Data,
- tworzyć skondensowane zestawienia i porównania odmian pod kątem określonych kryteriów klimatyczno-agrotechnicznych,
- aktualizować wiedzę agronomiczną w systemach eksperckich w sposób ciągły.
Dzięki temu rolnik lub doradca nie muszą samodzielnie analizować setek stron katalogów, ale otrzymują zintegrowaną, podsumowaną wiedzę, bezpośrednio powiązaną z danymi z ich gospodarstwa i regionu.
Znaczenie Big Data dla zrównoważonego rolnictwa i odporności na zmiany klimatu
Big Data i analiza danych klimatycznych nie służą wyłącznie maksymalizacji plonu. Równie istotne jest budowanie długoterminowej odporności gospodarstw na wahania klimatu i wspieranie zrównoważonych praktyk produkcji. W obliczu rosnącej presji na ograniczanie emisji, ochronę bioróżnorodności i efektywne gospodarowanie wodą, dane stają się fundamentem racjonalnych decyzji.
Ograniczanie ryzyka klimatycznego poprzez dywersyfikację odmian
Jednym z praktycznych wniosków płynących z analiz Big Data jest znaczenie dywersyfikacji odmian i gatunków w gospodarstwie. Zamiast koncentrować się na jednej, teoretycznie najbardziej plennej odmianie, często opłacalne jest rozłożenie ryzyka na kilka typów:
- odmiany o różnej długości okresu wegetacji,
- odmiany o zróżnicowanej tolerancji na suszę czy nadmiar wody,
- odmiany o różnych profilach odporności na choroby i szkodniki,
- gatunki alternatywne lepiej znoszące określone warunki klimatyczne.
Big Data pozwala oszacować, jak taka dywersyfikacja wpływa na stabilność plonu i dochodu w wieloleciu. Modele symulacyjne mogą np. pokazać, że wprowadzenie odmiany o nieco niższym potencjale plonu, ale bardzo wysokiej stabilności w latach trudnych, zmniejsza ryzyko głębokich strat, nawet jeśli średni plon w najlepszych latach będzie nieco niższy.
Efektywne gospodarowanie wodą i nawozami
Analiza klimatyczna w ujęciu Big Data jest nieodzowna przy planowaniu strategii nawadniania, gospodarowania wodą glebową i nawożenia. Informacje o prawdopodobnym rozkładzie opadów i okresach suszy pomagają:
- dobierać odmiany o różnym zapotrzebowaniu na wodę w kluczowych fazach rozwoju,
- optymalizować terminy nawożenia i dawki, aby minimalizować straty składników wypłukiwanych przez ulewne deszcze,
- planować inwestycje w nawadnianie tam, gdzie dane wskazują rosnące ryzyko długotrwałych niedoborów wody,
- utrzymywać odpowiedni bilans materii organicznej w glebie, co zwiększa jej pojemność wodną i stabilizuje plon.
Lepsze zrozumienie interakcji między klimatem, glebą i nawożeniem przekłada się nie tylko na wyższy plon, ale przede wszystkim na bardziej zrównoważone wykorzystanie zasobów, zmniejszenie emisji gazów cieplarnianych i ochronę jakości wód powierzchniowych i gruntowych.
Adaptacja struktur zasiewów do zmieniającego się klimatu
Dane klimatyczne analizowane w modelach Big Data pokazują przesuwanie się stref uprawy wielu gatunków roślin. Gatunki dotychczas typowe dla cieplejszych regionów zaczynają pojawiać się bardziej na północy, a te wrażliwe na wysokie temperatury wypierane są z niektórych obszarów. W praktyce oznacza to konieczność dynamicznej adaptacji struktur zasiewów:
- wprowadzanie nowych gatunków, bardziej odpornych na suszę i upał,
- ograniczanie udziału tych gatunków, które coraz częściej zawodzą w nowych warunkach klimatycznych,
- szukanie nisz rynkowych związanych z roślinami lepiej dostosowanymi do prognozowanych warunków,
- dostosowanie kalendarza prac polowych do zmieniającej się sezonowości.
Big Data pozwala testować wirtualnie różne scenariusze struktur zasiewów, oceniając ich stabilność i opłacalność w obliczu potencjalnych zmian klimatu. Na tej podstawie można podejmować bardziej świadome decyzje inwestycyjne dotyczące zakupu sprzętu, infrastruktury nawadniającej czy długoterminowych kontraktów z odbiorcami.
Przyszłość Big Data w rolnictwie: od danych do odpornego systemu żywnościowego
Analiza danych klimatycznych i Big Data w uprawach oraz rolnictwie staje się jednym z filarów nowoczesnego systemu żywnościowego. Im bardziej zmienny klimat, tym większe znaczenie ma umiejętne zarządzanie ryzykiem, oparte na wiedzy, a nie na przeczuciach. Dobór odmian roślin, oparty na zintegrowanych bazach danych, modelach klimatycznych i obserwacjach z tysięcy pól, staje się strategicznym narzędziem stabilizowania produkcji.
Przyszłość przyniesie dalszą integrację źródeł danych: od czujników w glebie i stacjach pogodowych, przez maszyny autonomiczne i drony, po globalne modele klimatyczne. Kluczem będzie zdolność ich łączenia, analizy i przekładania na język praktycznych zaleceń, zrozumiałych dla producentów. W tym procesie szczególną rolę odegrają sztuczna inteligencja, systemy eksperckie oraz modele językowe, które połączą świat złożonych algorytmów z codzienną praktyką na polu.
Big Data nie jest celem samym w sobie, lecz narzędziem umożliwiającym lepsze, bardziej świadome decyzje. Od tego, jak zostanie wykorzystane, zależeć będzie nie tylko rentowność pojedynczych gospodarstw, ale też odporność całego łańcucha dostaw żywności na wstrząsy klimatyczne i rynkowe. Analiza danych klimatycznych jako podstawa wyboru odmiany roślin to pierwszy, lecz ogromnie ważny krok na drodze do tak rozumianej transformacji rolnictwa.