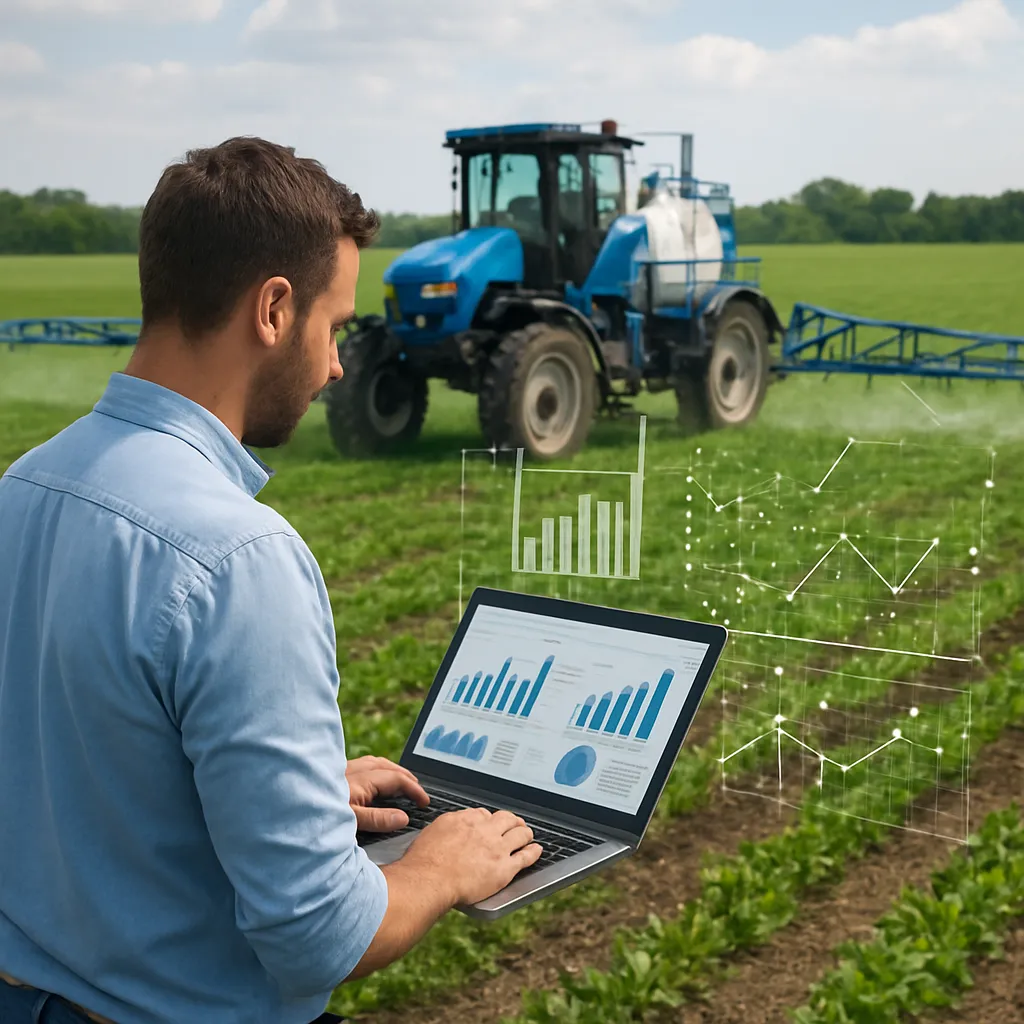
Rozwój technologii cyfrowych sprawił, że rolnictwo przestało być wyłącznie sztuką uprawy ziemi, a stało się jedną z najbardziej zaawansowanych dziedzin zastosowań analizy danych. Wraz z pojawieniem się narzędzi takich jak opryskiwacze z systemem kontroli sekcji, czujniki polowe, drony, systemy GPS oraz platformy satelitarne, producenci rolni zyskali dostęp do ogromnych wolumenów informacji. To właśnie te dane – gromadzone, integrowane i analizowane – tworzą fundament koncepcji Big Data w rolnictwie. Odpowiednio wykorzystane, pozwalają ograniczyć koszty, zwiększyć plony, poprawić efektywność nawożenia i ochrony roślin, a równocześnie ograniczyć wpływ na środowisko. Artykuł koncentruje się na analizie danych z opryskiwaczy wyposażonych w system kontroli sekcji, ale w szerszym kontekście inteligentnych upraw, rolnictwa precyzyjnego i ekosystemu Big Data w agrotechnice.
Big Data w rolnictwie – definicja, źródła danych i specyfika upraw
Big Data w sektorze rolnym to nie tylko duże zbiory informacji, lecz także zróżnicowane, szybko napływające i wymagające zaawansowanego przetwarzania dane, które powstają na każdym etapie produkcji roślinnej i zwierzęcej. Wyróżnia je szczególna zmienność w czasie i przestrzeni: rośliny rosną w dynamicznie zmieniającym się środowisku, a każdy fragment pola może reagować inaczej na nawożenie, nawadnianie czy zabiegi ochrony. Z tego powodu klasyczne metody zarządzania gospodarstwem, oparte na jednym planie dla całej działki, są coraz mniej efektywne. Big Data pozwala tę zmienność uchwycić, skwantyfikować i przekształcić w konkretne decyzje.
Do głównych źródeł danych w nowoczesnych uprawach zaliczamy:
- dane z maszyn rolniczych – ciągniki, siewniki, kombajny, opryskiwacze z systemem kontroli sekcji, rozsiewacze nawozów;
- dane z czujników polowych – stacje pogodowe, tensjometry, czujniki wilgotności gleby, sondy zasolenia;
- dane satelitarne i z dronów – obrazy wielospektralne, mapy NDVI, wskaźniki biomasy, mapy struktury gleby;
- dane laboratoryjne i glebowe – analizy zasobności w składniki pokarmowe, pH, zawartość próchnicy, tekstura;
- informacje ekonomiczne – ceny środków do produkcji, koszty paliwa, robocizny, dane rynkowe;
- dane organizacyjne – rejestry zabiegów, plan zasiewów, daty zbiorów, dokumentacja środków ochrony roślin.
Specyfika Big Data w uprawach polega też na silnym połączeniu informacji przestrzennych (mapy, współrzędne GPS, siatki pól) z informacjami czasowymi (harmonogram zabiegów, przebieg pogody, fazy rozwojowe roślin). W efekcie powstaje wielowymiarowa struktura danych, gdzie każdy punkt na mapie pola może mieć przypisaną historię: rodzaj uprawy, terminy siewu, dawki nawozów, ilość zużytej wody, historię presji chorobowej i zabiegów ochronnych.
W efektywnym zarządzaniu takimi zbiorami rolnik nie jest już w stanie polegać wyłącznie na intuicji. Potrzebne są systemy analizy, modele predykcyjne oraz oprogramowanie integrujące dane z wielu maszyn i platform. Istotną rolę zaczynają odgrywać również narzędzia oparte na sztucznej inteligencji i uczeniu maszynowym, które potrafią wykrywać zależności niewidoczne gołym okiem i sugerować optymalne warianty postępowania agrotechnicznego.
Rola opryskiwaczy z systemem kontroli sekcji w ekosystemie danych
Opryskiwacze wyposażone w systemy kontroli sekcji stały się jednym z najważniejszych elementów infrastruktury danych na polu. Oprócz wykonywania kluczowego zabiegu ochrony roślin, generują one precyzyjne informacje o rzeczywistym przebiegu oprysku, rozmieszczeniu dawki, obszarach wyłączonych (np. strefy ochronne, kliny, uwrocia) oraz nakładkach. To dane o bardzo wysokiej wartości – pozwalają ocenić, jak faktycznie wyglądał zabieg i gdzie pojawiają się rezerwy efektywności.
Jak działa system kontroli sekcji
System kontroli sekcji w opryskiwaczu polega na automatycznym włączaniu i wyłączaniu poszczególnych sekcji belki na podstawie pozycji GPS i mapy pola. Działanie można opisać w kilku krokach:
- opracowanie granic pola i stref wyłączonych (np. zbiorniki wodne, miedze, strefy buforowe) w postaci cyfrowej mapy;
- pozycjonowanie opryskiwacza na podstawie sygnału GPS lub GNSS o zwiększonej dokładności (RTK, EGNOS itp.);
- ciągłe porównywanie aktualnej pozycji każdej sekcji belki z mapą obszarów już opryskanych;
- automatyczne wyłączanie sekcji w miejscach, gdzie nastąpiłoby powtórne naniesienie cieczy roboczej (nakładka) lub gdzie zabieg jest zabroniony;
- opcjonalne sterowanie dawką w czasie rzeczywistym, jeżeli opryskiwacz współpracuje z mapą zmiennego dawkowania lub czujnikami biomasy.
W trakcie pracy rejestrowany jest szereg parametrów pracy opryskiwacza: prędkość, ciśnienie cieczy, dawka, włączenie i wyłączenie poszczególnych sekcji, ilość cieczy zużytej na danym fragmencie pola. Dane te są zapisywane w pamięci terminala, a następnie mogą być eksportowane do komputera gospodarstwa lub do platformy chmurowej.
Znaczenie danych z opryskiwaczy dla analizy upraw
Dane pochodzące z opryskiwaczy z systemem kontroli sekcji mają kilka kluczowych zastosowań w rolnictwie precyzyjnym:
- Dokładne określenie rzeczywistej dawki i równomierności pokrycia – analiza map zabiegu pozwala ocenić, czy na całej powierzchni uprawy utrzymano wymaganą dawkę środka ochrony roślin. W połączeniu z danymi o skuteczności zabiegu (np. presja chwastów, chorób) umożliwia korektę strategii ochrony;
- Identyfikacja nakładek i omijaków – dzięki przestrzennej analizie widać, gdzie nastąpiło powtórne opryskanie danego obszaru lub jego pominięcie. Ma to znaczenie zarówno ekonomiczne (koszt środka, paliwa), jak i regulacyjne (ryzyko przekroczenia dopuszczalnych dawek);
- Optymalizacja szerokości roboczej i przejazdów – na podstawie historii pracy sekcji można przeanalizować, jak ukształtowanie pola, poprzeczniaki i kliny wpływają na straty czasu i środków. Ułatwia to optymalizację ścieżek technologicznych i organizację pracy;
- Integracja z innymi danymi – mapy z opryskiwaczy można łączyć z mapami plonu, mapami zasobności gleby, danymi satelitarnymi czy rejestrem zabiegów. W ten sposób powstaje pełniejszy obraz zależności pomiędzy ochroną roślin a wynikami produkcyjnymi;
- Weryfikacja zgodności z dobrą praktyką rolniczą – dane z oprysku stanowią dowód prawidłowego wykonania zabiegu w kontekście wymogów środowiskowych i jakościowych. W przypadku audytów lub kontroli mogą potwierdzić utrzymanie odpowiednich stref buforowych i terminów.
Warto podkreślić, że informacje zebrane w trakcie jednego sezonu z pojedynczego opryskiwacza są stosunkowo niewielkie w porównaniu z ogólną koncepcją Big Data. Jednak jeżeli dane z kilkudziesięciu zabiegów, z wielu lat i wielu pól zostaną zintegrowane, powstaje bogaty zasób wiedzy. Dodając do tego dane z innych maszyn – siewników, rozsiewaczy, kombajnów – gospodarstwo tworzy własną, unikalną bazę do analizy i modelowania.
Integracja danych maszynowych, satelitarnych i glebowych – fundament rolnictwa precyzyjnego
Kluczowa korzyść z Big Data w uprawach pojawia się dopiero wtedy, gdy informacje z opryskiwaczy z systemem kontroli sekcji są łączone z innymi źródłami. Tylko integracja danych umożliwia pełne zrozumienie, dlaczego w określonych częściach pola plon jest wyższy lub niższy, skąd biorą się różnice w presji chorób, a także jak kształtuje się efektywność ekonomiczna poszczególnych zabiegów.
Łączenie danych z maszyn z danymi satelitarnymi
Dane satelitarne, dostarczane przez systemy takie jak Sentinel czy Landsat, pozwalają monitorować wegetację roślin w regularnych odstępach czasu. Na ich podstawie oblicza się wskaźniki wegetacyjne – najczęściej NDVI, ale także inne, np. EVI czy SAVI. Łączenie tych wskaźników z mapami wykonanych oprysków daje możliwość:
- oceny wpływu danego zabiegu ochrony na kondycję roślin – porównuje się wskaźniki roślinności przed opryskiem i po oprysku, z uwzględnieniem warunków pogodowych;
- identyfikacji obszarów o słabszej reakcji na zabiegi – jeżeli część pola po oprysku i nawożeniu wciąż wykazuje niższe wartości wskaźników wegetacyjnych, może to wskazywać na problemy glebowe lub błędnie dobraną strategię ochrony;
- planowania zmiennego dawkowania środków ochrony roślin – na podstawie różnic w biomasy i gęstości łanu można tworzyć mapy aplikacyjne, które następnie wykorzystuje opryskiwacz z kontrolą sekcji i sterowaniem dawką.
Opryskiwacze generują dokładne informacje o czasie i miejscu zabiegu, natomiast satelity dostarczają informacji o reakcji roślin. Połączenie tych dwóch światów stanowi podstawę systemów rekomendacyjnych i predykcyjnych, które mogą sugerować optymalne terminy kolejnych zabiegów, przewidywać rozwój chorób, a także oceniać ryzyko strat plonu.
Integracja z danymi glebowymi i mapami plonu
Dane glebowe – w tym mapy zasobności w fosfor, potas, magnez, wapń, mikroelementy, a także parametry takie jak pH, zawartość próchnicy czy kategoria agronomiczna – są fundamentem długoterminowego zarządzania żyznością pól. Gdy połączymy je z:
- mapami zabiegów z opryskiwaczy (rodzaj środka, dawka, termin);
- mapami siewu (obsada, odmiana, głębokość siewu);
- mapami rozsiewu nawozów (dawki startowe, pogłówne, mikrogranulaty);
- mapami plonów z kombajnów (ilość plonu, wilgotność, czas zbioru);
uzyskujemy wielowymiarową bazę danych, która pozwala odtworzyć pełną historię agronomiczną każdego fragmentu pola. Analiza takiego zbioru może prowadzić do odpowiedzi na pytania:
- które kombinacje nawożenia, ochrony i odmian dają najwyższy plon w konkretnych warunkach glebowych;
- czy wyższe dawki fungicydów lub herbicydów przekładają się na proporcjonalny wzrost plonu, czy jedynie zwiększają koszty;
- jaką część zmienności w plonowaniu można wyjaśnić parametrami gleby, a jaką praktyką agrotechniczną;
- czy dany fragment pola jest podatny na specyficzne choroby lub chwasty, co uzasadnia celowane zabiegi w kolejnych sezonach;
- jak kształtuje się długoterminowy bilans składników pokarmowych i czy ich pobór przez rośliny jest zgodny z dawkami aplikowanymi w nawozach i środkach ochrony roślin.
Na podstawie takich analiz powstają rekomendacje dla zmiennego nawożenia, selekcji odmian czy różnicowania strategii ochrony roślin na poszczególnych polach. Dane z opryskiwaczy z kontrolą sekcji są jednym z kluczowych ogniw łańcucha informacyjnego, ponieważ wiążą parametry środowiskowe z konkretnymi decyzjami agrotechnicznymi.
Znaczenie standardów danych i platform wymiany informacji
Efektywne wykorzystanie Big Data w uprawach wymaga, aby dane generowane przez różne maszyny i systemy dało się ze sobą łączyć. Dlatego rosnącą rolę odgrywają standardy wymiany danych (np. formaty ISOXML, shapefile, GeoJSON) oraz platformy integrujące informacje z wielu marek. Bez wspólnych protokołów i otwartych interfejsów API analiza przekrojowa byłaby bardzo utrudniona.
Nowoczesne systemy zarządzania gospodarstwem (FMIS) umożliwiają import danych z opryskiwaczy, ich wizualizację na mapie oraz powiązanie z innymi rejestrami. Dzięki temu rolnik nie tylko widzi, gdzie i kiedy wykonał zabieg, ale może także:
- od razu powiązać go z danymi kosztowymi (ilość zużytego środka, paliwo, robocizna);
- sprawdzić wpływ konkretnego zabiegu na wynik końcowy (plon, jakość ziarna, parametry technologiczne);
- porównać skuteczność alternatywnych środków lub strategii ochrony stosowanych na różnych polach.
Algorytmy analityczne, AI i modele predykcyjne w ochronie roślin
Sam zbiór danych nie gwarantuje sukcesu – kluczowe jest ich przetwarzanie i interpretacja. W rolnictwie szybko rośnie znaczenie algorytmów analitycznych, systemów ekspertowych i narzędzi opartych na sztucznej inteligencji, które są w stanie przetwarzać ogromne wolumeny danych z wielu sezonów. Zadaniem tych narzędzi jest nie tylko opis przeszłości, ale także tworzenie prognoz i rekomendacji dotyczących przyszłych działań.
Modele predykcyjne chorób i szkodników
Jednym z najbardziej perspektywicznych obszarów zastosowania Big Data w uprawach są modele predykcyjne występowania chorób i szkodników. Wykorzystują one:
- dane pogodowe (temperatura, opady, wilgotność, okresy zwilżenia liści);
- informacje o fazie rozwojowej roślin (BBCH);
- historię zabiegów z opryskiwaczy z kontrolą sekcji (rodzaj środka, dawka, data);
- informacje o odmianie, gęstości siewu i strukturze zasiewów w okolicy;
- mapy glebowe oraz dane o ukształtowaniu terenu, które wpływają na mikroklimat.
Na podstawie tych danych modele wyliczają ryzyko infekcji lub pojawu szkodnika w danym oknie czasowym i na konkretnym obszarze pola. System może zaproponować:
- optymalny termin zabiegu ochronnego, tak aby maksymalnie zmniejszyć ryzyko strat plonu;
- dostosowanie dawki środka do spodziewanej presji chorobowej;
- rezygnację z zabiegu tam, gdzie prawdopodobieństwo silnej infekcji jest niewielkie.
Takie podejście poszerza korzyści wynikające z użycia opryskiwacza z systemem kontroli sekcji. O ile sama automatyka sekcji zapobiega fizycznym nakładkom i niepotrzebnemu opryskowi, o tyle modele predykcyjne pozwalają uniknąć zabiegów nieuzasadnionych z punktu widzenia ryzyka chorobowego. W rezultacie rośnie efektywność ekonomiczna i środowiskowa całego systemu.
Uczenie maszynowe w analizie danych z opryskiwaczy
Uczenie maszynowe znajduje zastosowanie m.in. w analizie historycznych zbiorów danych z opryskiwaczy w połączeniu z plonami i danymi pogodowymi. Typowe zadania obejmują:
- identyfikację wzorców, w których określone dawki i kombinacje środków dają optymalny zwrot z inwestycji w danym typie pola;
- wykrywanie anomalii – np. fragmentów pola, gdzie mimo wysokiej intensywności zabiegów plon pozostaje niski, co może sugerować problemy glebowe lub błędy w wykonaniu prac;
- klasyfikację stref pola pod kątem rekomendowanych strategii ochrony (strefy wysokiego, średniego i niskiego ryzyka);
- optymalizację tras przejazdów opryskiwacza w celu minimalizacji przejazdów jałowych i czasu pracy.
Algorytmy mogą wykorzystywać zarówno dane liczbowe, jak i przestrzenne. W przypadku danych przestrzennych, ważnym narzędziem jest geostatystyka oraz metody takie jak kriging, które umożliwiają interpolację i analizę zależności przestrzennych. Współczesne rozwiązania łączą techniki geoinformatyczne z uczeniem maszynowym, budując zaawansowane, adaptacyjne systemy wsparcia decyzji dla działań ochronnych i nawozowych.
Rola Big Data w optymalizacji zużycia środków ochrony roślin
Jednym z praktycznych celów analizy danych w uprawach jest ograniczenie zużycia środków chemicznych przy zachowaniu lub zwiększeniu skuteczności ochrony. Dzięki precyzyjnym mapom zabiegów z opryskiwaczy z kontrolą sekcji można:
- dokładnie policzyć, ile środka zużyto na poszczególnych polach i w ramach konkretnych upraw;
- porównać zużycie pomiędzy sezonami, uwzględniając różnice w warunkach pogodowych i presji chorób;
- ocenić realne oszczędności wynikające z eliminacji nakładek – zarówno w ujęciu kosztowym, jak i środowiskowym;
- dostosować dawki i częstotliwość zabiegów do lokalnej historii pola i jego stref ryzyka.
W dłuższym okresie dane te pozwalają budować strategie redukcji intensywności ochrony przy równoczesnym utrzymaniu wysokiego poziomu bezpieczeństwa plonu. Jest to istotne w kontekście rosnących wymagań regulacyjnych w zakresie ograniczania użycia środków ochrony roślin oraz oczekiwań konsumentów dotyczących produkcji żywności o mniejszym śladzie środowiskowym.
Aspekty praktyczne, organizacyjne i ekonomiczne wdrażania Big Data w gospodarstwie
Wykorzystanie potencjału Big Data w uprawach wymaga nie tylko zakupu odpowiednich maszyn i czujników, ale również zmian w organizacji pracy gospodarstwa, podejściu do rejestrowania danych oraz metodzie podejmowania decyzji. Szczególne znaczenie ma tu systematyczne gromadzenie i porządkowanie informacji.
Budowa infrastruktury danych w gospodarstwie
Podstawą jest stworzenie spójnej infrastruktury informacyjnej, obejmującej:
- maszyny generujące dane – ciągniki z terminalami, opryskiwacze z kontrolą sekcji, kombajny z czujnikami plonu, rozsiewacze z systemem zmiennej dawki;
- oprogramowanie do gromadzenia danych – systemy zarządzania gospodarstwem, aplikacje do importu i wizualizacji map, narzędzia do analiz;
- archiwum danych – bezpieczne przechowywanie, regularne kopie zapasowe, uporządkowana struktura katalogów lub baza w chmurze;
- standardy opisu zabiegów – spójne nazewnictwo pól, upraw, odmian, środków ochrony, tak aby można było sensownie łączyć dane z różnych lat.
Szczególnie ważne jest, aby dane z opryskiwaczy były systematycznie eksportowane, opisywane i przypisywane do konkretnych kampanii polowych. Bez tego trudno będzie budować wiarygodne modele i raporty, które obejmują wiele sezonów. Niezbędna jest również podstawowa wiedza z zakresu geoinformatyki – rozumienie map, współrzędnych, warstw tematycznych oraz sposobów ich nakładania i filtrowania.
Kompetencje cyfrowe i praca z danymi
Wdrażanie Big Data w uprawach wymaga od rolnika lub doradcy nowych umiejętności. Oprócz znajomości klasycznej agrotechniki i ochrony roślin, konieczne stają się:
- kompetencje w obsłudze terminali, oprogramowania rolniczego oraz platform internetowych;
- rozumienie podstawowych pojęć statystycznych (próba, rozkład, korelacja, regresja, wariancja);
- umiejętność interpretacji map tematycznych i wyników analiz – co oznacza strefa o niższym plonie, jak odczytać mapę nakładek, jak interpretować wskaźniki roślinności;
- świadomość ograniczeń danych – zrozumienie, że każdy pomiar ma pewien błąd, a modele predykcyjne działają z określonym poziomem niepewności.
W praktyce wiele gospodarstw korzysta z pomocy zewnętrznych doradców lub firm specjalizujących się w rolnictwie cyfrowym. Jednak nawet w takiej sytuacji warto, aby właściciel lub kierownik gospodarstwa rozumiał logikę analizy danych. Bez tego trudno będzie ocenić, czy proponowane wnioski i rekomendacje są sensowne oraz czy odpowiadają realiom konkretnego gospodarstwa.
Ekonomiczna ocena inwestycji w systemy z kontrolą sekcji i analitykę
Wdrożenie opryskiwaczy z systemem kontroli sekcji oraz infrastruktury Big Data wiąże się z dodatkowymi kosztami inwestycyjnymi. Dlatego istotne jest przeprowadzenie analizy zwrotu z inwestycji (ROI), uwzględniającej:
- oszczędności środków ochrony roślin wynikające z redukcji nakładek i dokładniejszego dawkowania;
- oszczędności paliwa i czasu pracy dzięki lepszej organizacji przejazdów;
- wzrost plonu lub jakości płodów dzięki bardziej precyzyjnym zabiegom i lepszej reakcji na warunki pogodowe;
- zmniejszenie ryzyka strat wynikających z błędnych decyzji (np. zbyt późnych zabiegów czy niepotrzebnych oprysków);
- korzystny wpływ dowodów w postaci zapisów zabiegów na współpracę z odbiorcami, certyfikacją i ubezpieczycielami.
Analiza ekonomiczna powinna być prowadzona w oparciu o konkretne dane z pola – zużycie środków przed wdrożeniem systemu kontroli sekcji i po jego wdrożeniu, zmiany w plonach, przesunięcia terminów zabiegów. Dopiero wtedy można rzetelnie ocenić, czy inwestycja przyniosła oczekiwane efekty.
W perspektywie kilku lat do gry wchodzi jeszcze jedna wartość – zgromadzone dane historyczne stają się kapitałem gospodarstwa. Umożliwiają ciągłą optymalizację strategii upraw, szybsze reagowanie na zmiany klimatyczne oraz lepsze dostosowanie się do wymogów rynkowych i regulacyjnych.
Znaczenie Big Data dla zrównoważonego rolnictwa i przyszłości upraw
Big Data w uprawach i rolnictwie łączy cele ekonomiczne z celami środowiskowymi. Analiza danych z opryskiwaczy z systemem kontroli sekcji oraz innych maszyn pozwala z jednej strony obniżyć koszty i zwiększyć produktywność, z drugiej – zmniejszyć presję na ekosystemy i ograniczyć zużycie chemii. Takie podejście wpisuje się w koncepcję rolnictwa zrównoważonego oraz europejskich strategii ograniczania emisji i ochrony bioróżnorodności.
Dzięki szczegółowym mapom zabiegów i precyzyjnym danym przestrzennym możliwe jest utrzymanie stref buforowych przy ciekach wodnych, ochrona obszarów cennych przyrodniczo, a także dokładne dokumentowanie działań prośrodowiskowych. Dodatkowo, łączenie danych o nawożeniu, ochronie i plonach pozwala lepiej zarządzać bilansem składników pokarmowych, minimalizując ryzyko ich wypłukiwania i eutrofizacji wód.
Wraz z rozwojem technologii, takich jak Internet Rzeczy (IoT), sieci sensorów polowych oraz zaawansowane systemy prognozowania pogody, zakres dostępnych danych będzie się powiększał. Opryskiwacze z kontrolą sekcji staną się jeszcze ściślej zintegrowane z innymi urządzeniami – na przykład będą automatycznie dostosowywać dawkę do bieżącej wilgotności liści, wiatru czy sygnałów z czujników chorobowych. Wzrośnie również rola algorytmów sztucznej inteligencji, które będą podejmować część decyzji w czasie rzeczywistym.
W tym kontekście budowanie kompetencji w zakresie analizy danych oraz świadome korzystanie z Big Data w gospodarstwie stanie się jednym z kluczowych czynników konkurencyjności. Gospodarstwa, które potrafią przekształcić dane z opryskiwaczy, maszyn i satelitów w precyzyjne działania na polu, zyskają przewagę zarówno na poziomie kosztów, jak i jakości produkcji. Big Data nie jest bowiem celem samym w sobie, lecz narzędziem prowadzącym do bardziej efektywnego, zrównoważonego i odpornego na zmiany środowiskowe rolnictwa.